Kurz gesagt
Eine KI-Halluzination ist eine Ausgabe, die ein KI-Modell überzeugend formuliert, die aber falsch oder erfunden ist, etwa ein nicht existierendes Urteil oder Softwarepaket. Sie entsteht, weil Sprachmodelle wahrscheinliche Wortfolgen erzeugen und Training wie Bewertung das Raten belohnen. Vollständig verhindern lässt sie sich nicht, wohl aber durch Belege, Prüfungen und Freigaben eingrenzen.
Was ist eine KI-Halluzination?
Eine KI-Halluzination ist eine Ausgabe eines generativen KI-Modells, die selbstsicher formuliert, aber sachlich falsch oder frei erfunden ist. Das US-Standardisierungsinstitut NIST verwendet dafür den Fachbegriff Konfabulation und beschreibt damit selbstsicher präsentierte falsche Inhalte.
Nach NIST zählen auch Ausgaben dazu, die von der Eingabe abweichen oder früheren Aussagen im selben Gespräch widersprechen. Ein Modell, das ein beigefügtes Dokument falsch zusammenfasst, halluziniert also ebenfalls, obwohl die richtige Antwort vorlag.
Halluzinationen betreffen alle Formen generativer KI. Im Unternehmen sind sie ein Teil der KI-Sicherheit, weil falsche Ausgaben in Entscheidungen, Verträge, Code und automatisierte Abläufe einfließen.
Warum halluzinieren Sprachmodelle?
Sprachmodelle sagen das wahrscheinlichste nächste Wort voraus. NIST beschreibt Konfabulationen als natürliche Folge dieses Designs: Die Vorhersage kann korrekte Aussagen liefern, aber auch faktisch falsche oder in sich widersprüchliche. Besonders anfällig sind offene Fragen mit langen Antworten und Fachgebiete, die viel Kontextwissen verlangen.
Ein Forschungsteam um Adam Tauman Kalai zeigt in einem Paper vom September 2025 eine zweite Ursache: Training und Bewertung belohnen das Raten. Wer in Benchmarks bei Unsicherheit eine Antwort rät, schneidet besser ab als ein Modell, das Unwissen zugibt. Die Autoren fordern deshalb, die Bewertung verbreiteter Benchmarks zu ändern.
OWASP nennt in der Top 10 für LLM-Anwendungen 2025 zusätzlich Lücken und Verzerrungen in den Trainingsdaten. Das Modell füllt fehlendes Wissen mit statistischen Mustern auf, und die Antwort klingt trotzdem plausibel.
Beispiele: Wenn KI-Halluzinationen Folgen haben
Die folgenden Fälle sind durch Gerichtsdokumente, Behördenverfahren oder wissenschaftliche Studien belegt. Sie zeigen vier typische Schadensbilder: falsche Rechtsquellen, falsche Kundenauskünfte, falsche Aussagen über Personen und erfundene Softwarepakete.
| Fall | Was passierte | Folge |
|---|---|---|
| Mata v. Avianca, US District Court S.D.N.Y., 22-cv-1461 (PKC) | Anwälte reichten von ChatGPT erzeugte, nicht existierende Urteile mit erfundenen Zitaten ein. | Sanktion von 5.000 US-Dollar laut Beschluss vom 22.06.2023 |
| Moffatt gegen Air Canada, Civil Resolution Tribunal British Columbia | Der Chatbot der Airline gab eine falsche Auskunft zu einem Trauerfalltarif. | Laut Bericht vom Februar 2024 musste die Airline gut 650 Dollar Schadenersatz zahlen |
| noyb gegen OpenAI, Beschwerde bei der norwegischen Datenschutzbehörde | ChatGPT stellte einen Norweger fälschlich als verurteilten Mörder dar. | Beschwerde wegen Verstoß gegen Art. 5 Abs. 1 lit. d DSGVO (März 2025) |
| Paket-Halluzinationen, Studie für USENIX Security 2025 | 16 Modelle erzeugten 576.000 Code-Beispiele mit 205.474 erfundenen Paketnamen. | Halluzinierte Pakete: mindestens 5,2 % bei kommerziellen, 21,7 % bei Open-Source-Modellen |
Warum Halluzinationen bei KI-Agenten teurer werden
Bei einem Chatbot liest ein Mensch die falsche Antwort und kann sie bemerken. Ein KI-Agent setzt sie direkt um: Er installiert ein Paket, schreibt eine Mail an eine erfundene Adresse oder trägt einen falschen Betrag in ein System ein. Je mehr Schritte ohne Kontrolle laufen, desto weiter trägt sich der Fehler fort.
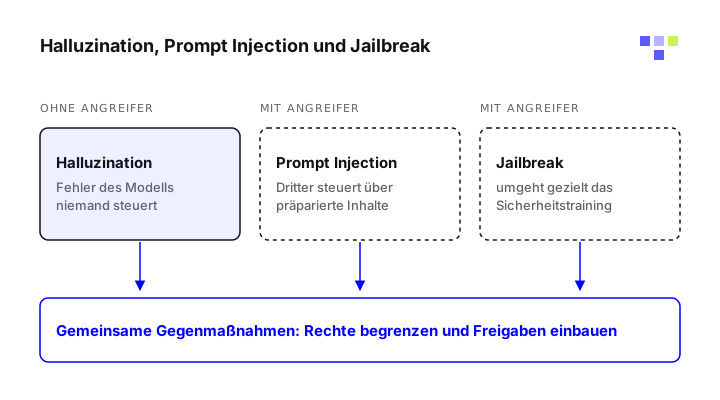
Besonders deutlich wird das bei Coding-Agenten. OWASP beschreibt, dass Angreifer halluzinierte Paketnamen gezielt suchen und unter diesen Namen Schadcode veröffentlichen. Ein Agent, der den Vorschlag ungeprüft installiert, holt sich damit selbst eine Hintertür ins System.
NIST weist auf ein weiteres Muster hin: Modelle liefern auch erfundene Begründungen oder Quellen, die eine falsche Antwort stützen. Das erhöht das Vertrauen der Nutzer genau dort, wo es nicht angebracht ist. Ein Protokoll der Agentenschritte hilft, solche Fehlerketten im Nachhinein zu finden.
Halluzination, Prompt Injection und Jailbreak: die Abgrenzung
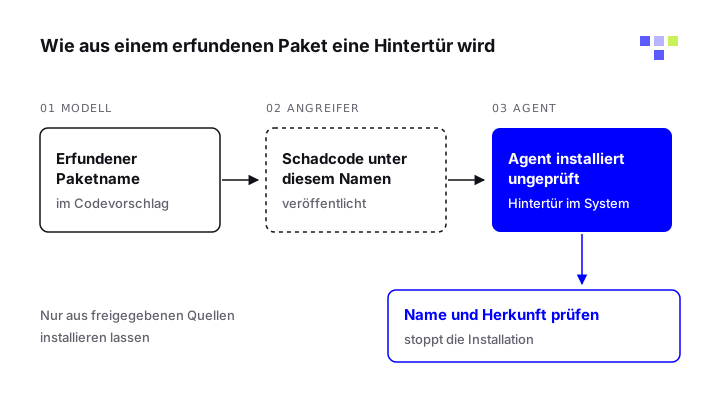
Eine Halluzination ist ein Fehler des Modells ohne Angreifer. Bei einer Prompt Injection steuert ein Dritter das Modell absichtlich über präparierte Inhalte, bei einem KI-Jailbreak umgeht jemand gezielt das Sicherheitstraining.
In der Praxis greifen die Themen ineinander. Die Paket-Halluzination ist ein Beispiel: Der Fehler entsteht ohne Angreifer, wird aber von Angreifern ausgenutzt. Die Gegenmaßnahmen überschneiden sich deshalb, vor allem bei Rechten und Freigaben.
Was bedeuten Halluzinationen rechtlich?
Betrifft eine falsche Ausgabe eine Person, berührt sie den Grundsatz der Richtigkeit nach Art. 5 Abs. 1 lit. d DSGVO und das Recht auf Berichtigung nach Art. 16 DSGVO. Die Datenschutzkonferenz schreibt in ihrer Orientierungshilfe vom Mai 2024, dass Ergebnisse von KI-Anwendungen mit Personenbezug kritisch hinterfragt und vor der Weiterverarbeitung überprüft werden müssen.
Ein Hinweis wie „KI kann Fehler machen“ ersetzt diese Prüfung nicht. Diese Auffassung vertritt noyb in der Beschwerde gegen OpenAI. Für Hochrisiko-KI-Systeme verlangt Artikel 15 der KI-Verordnung (EU) 2024/1689 zudem ein angemessenes Maß an Genauigkeit über den gesamten Lebenszyklus. Mehr zur Datenseite lesen Sie unter KI und Datenschutz.
Gegenmaßnahmen: KI-Halluzinationen im Unternehmen eingrenzen
Anthropic schreibt in seiner Entwicklerdokumentation, dass die folgenden Techniken Halluzinationen deutlich reduzieren, aber nicht vollständig beseitigen. Kritische Informationen sollten Sie deshalb immer prüfen. Die Schritte verbinden Hinweise von Anthropic, OWASP und DSK mit den vier Regeln für Agenten.
Antworten an Quellen binden
Geben Sie dem Modell geprüfte Dokumente mit und weisen Sie es an, nur daraus zu antworten. OWASP nennt dafür Retrieval-Augmented Generation (RAG) mit vertrauenswürdigen Quellen.
Unwissen erlauben
Erlauben Sie dem Modell ausdrücklich, „Ich weiß es nicht“ zu sagen. Laut Anthropic senkt das falsche Angaben spürbar.
Belege verlangen
Lassen Sie jede Aussage mit einem wörtlichen Zitat aus der Quelle belegen und Aussagen ohne Beleg streichen. Das macht Antworten nachprüfbar.
Automatisch prüfen
Prüfen Sie, was sich maschinell prüfen lässt: ob ein Paket in der offiziellen Registry existiert, ob ein Aktenzeichen in einer Datenbank steht, ob ein Betrag zur Rechnung passt.
Rechte begrenzen
Ein Agent darf nur aus freigegebenen Quellen installieren und nur auf die Systeme schreiben, die seine Aufgabe erfordert.
Freigaben einbauen
Ausgaben mit Außenwirkung wie Schriftsätze, Kundenauskünfte oder Zahlungen prüft ein Mensch, bevor sie wirksam werden. Mehr dazu unter Human in the Loop.
Protokollieren
Speichern Sie Eingaben, genutzte Quellen und Werkzeugaufrufe. So finden Sie heraus, an welcher Stelle eine falsche Angabe entstanden ist.
Kein Anbieter garantiert halluzinationsfreie Ausgaben. Planen Sie Prozesse so, dass eine falsche Antwort auffällt, bevor sie Schaden anrichtet.
Checkliste für Unternehmen
- Für jeden KI-Einsatz ist festgelegt, wer die Ergebnisse vor der Verwendung prüft.
- Fachliche Antworten stützen sich auf mitgegebene, geprüfte Dokumente.
- Zitate, Urteile und Zahlen werden an der Originalquelle nachgeschlagen.
- Coding-Agenten installieren Pakete nur nach Prüfung von Name und Herkunft.
- Kundenkommunikation durch Chatbots wird stichprobenartig kontrolliert.
- Beschäftigte wissen aus Schulungen, wie Halluzinationen aussehen.
Häufige Fragen
Kann man KI-Halluzinationen vollständig verhindern?
Nein. NIST beschreibt Konfabulationen als natürliche Folge der Funktionsweise generativer Modelle, und auch Anthropic schreibt, dass Gegenmaßnahmen Halluzinationen reduzieren, aber nicht beseitigen. Ziel ist, falsche Ausgaben zu erkennen, bevor sie wirken.
Warum erfindet ChatGPT Quellen und Urteile?
Das Modell erzeugt Text, der wie eine Quellenangabe aussieht, ohne eine Datenbank abzufragen. Im Fall Mata v. Avianca reichten Anwälte so erzeugte Urteile ungeprüft bei Gericht ein. Prüfen Sie Quellen deshalb immer am Original.
Hilft RAG gegen Halluzinationen?
RAG verringert Halluzinationen, weil das Modell aus mitgegebenen Dokumenten antwortet. OWASP empfiehlt es ausdrücklich. Das Modell kann die Dokumente trotzdem falsch wiedergeben, deshalb bleiben Belegpflicht und Prüfung nötig.
Welches KI-Modell halluziniert am wenigsten?
Das hängt von Aufgabe, Fachgebiet und Modellversion ab und ändert sich mit jedem Update. Testen Sie Modelle mit Fragen aus Ihrem eigenen Einsatzgebiet, deren richtige Antworten Sie kennen.
Müssen Unternehmen KI-Ergebnisse prüfen?
Bei personenbezogenen Ergebnissen fordert die Datenschutzkonferenz eine Überprüfung vor der Weiterverarbeitung, weil unrichtige Ergebnisse zu unzulässigen Verarbeitungen führen können. Für alle anderen Ergebnisse ist die Prüfung eine Frage des Risikos, das ein Fehler auslöst.
Quellen
- Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1), NIST
- LLM09:2025 Misinformation, OWASP GenAI Security Project
- Why Language Models Hallucinate, Kalai, Nachum, Vempala, Zhang (arXiv)
- We Have a Package for You! A Comprehensive Analysis of Package Hallucinations by Code Generating LLMs, Spracklen u. a. (arXiv, USENIX Security 2025)
- Mata v. Avianca, Inc., 22-cv-1461 (PKC), Opinion and Order on Sanctions, US District Court S.D.N.Y. (via CourtListener)
- Air Canada chatbot error: B.C. tribunal ruling, Global News
- AI hallucinations: ChatGPT created a fake child murderer, noyb
- Orientierungshilfe Künstliche Intelligenz und Datenschutz (6. Mai 2024), Datenschutzkonferenz (DSK)
- Reduce hallucinations, Anthropic (Claude-Dokumentation)