Kurz gesagt
Ein ChatGPT Jailbreak ist eine Eingabe, die ein Sprachmodell dazu bringt, sein im Training erlerntes Sicherheitsverhalten zu umgehen. Jailbreaks gelten als Form der Prompt Injection. Bei KI-Agenten lösen sie Aktionen mit echten Rechten aus, etwa Mailversand oder Dateizugriffe. Schutz bieten begrenzte Rechte, menschliche Freigaben, getrennte Eingaben und Protokolle.
Was ist ein ChatGPT Jailbreak?
Ein ChatGPT Jailbreak ist ein Versuch, ein Sprachmodell wie ChatGPT, Claude oder Gemini mit einer gezielt formulierten Eingabe dazu zu bringen, Inhalte zu erzeugen oder Handlungen auszuführen, die der Anbieter ausgeschlossen hat. Der Begriff stammt aus der Smartphone-Welt, wo ein Jailbreak die Sperren des Herstellers aufhebt.
Das BSI definiert Jailbreaks in seinem Leitfaden zu Evasion-Angriffen als Klasse von Angriffen, bei denen ein Nutzer-Prompt das während des Trainings erlernte Verhalten des Modells verändert. Kommt der auslösende Text aus Inhalten Dritter, etwa einer Webseite oder einem Dokument, spricht das BSI von einem indirekten Jailbreak.
OWASP ordnet Jailbreaking in der Top 10 für LLM-Anwendungen 2025 als Form der Prompt Injection ein. Das Modell ignoriert dabei seine Sicherheitsprotokolle vollständig. Für Unternehmen zählt die Folge: Ein Modell, das seine Regeln ablegt, ist kein verlässlicher Baustein mehr in einem Geschäftsprozess.
Jailbreak und Prompt Injection: der Unterschied
Beide Begriffe werden oft gleich verwendet. Das BSI trennt sie nach dem Ziel des Angriffs: Eine Prompt Injection hebelt die Vorgaben des Entwicklers im System-Prompt aus, ein Jailbreak das Sicherheitstraining des Modells selbst. In der Praxis treten beide oft zusammen auf.
Für die Abwehr ist die zweite Unterscheidung wichtiger: Kommt der Angriff vom Nutzer selbst oder über Inhalte, die ein Agent liest? Die zweite Variante beschreibt die Seite zur indirekten Prompt Injection ausführlich.
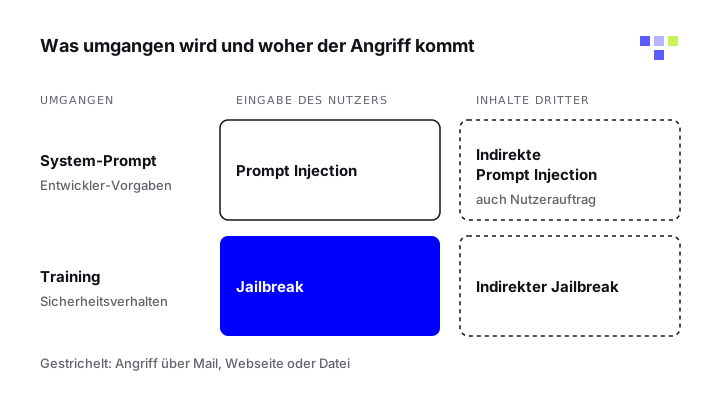
| Begriff | Was wird umgangen | Woher kommt der Angriff |
|---|---|---|
| Prompt Injection | Vorgaben im System-Prompt | Eingabe des Nutzers |
| Indirekte Prompt Injection | System-Prompt oder Nutzerauftrag | Inhalte Dritter, etwa Mail, Webseite, Datei |
| Jailbreak | Im Training erlerntes Sicherheitsverhalten | Eingabe des Nutzers |
| Indirekter Jailbreak | Im Training erlerntes Sicherheitsverhalten | Inhalte Dritter |
Welche Kategorien von Jailbreaks gibt es?
Jailbreaks lassen sich nach ihrem Mechanismus ordnen. Das BSI unterscheidet zwei Gruppen: kohärenten Text, den auch Menschen verstehen, und inkohärenten Text aus scheinbar zufälligen Zeichenfolgen. Jede Technik kann als universeller Schlüssel auftreten, der bei vielen Anfragen wirkt. Angreifer kombinieren Techniken oder verteilen Fragmente über mehrere Quellen, die einzeln harmlos aussehen.
Die folgende Übersicht beschreibt nur die Prinzipien, ohne funktionierende Angriffstexte.
| Kategorie | Prinzip | Beschrieben von |
|---|---|---|
| Rollenspiel | Das Modell soll eine Rolle annehmen, für die seine Regeln angeblich nicht gelten. | BSI |
| Mehrstufige Eskalation | Harmlose Fragen steigern sich über viele Runden und bauen auf den eigenen Antworten des Modells auf (Crescendo). | BSI, Russinovich u. a. (Microsoft) |
| Many-shot | Ein sehr langer Prompt enthält viele erfundene Dialoge, in denen ein Assistent Regeln bricht. | Anthropic |
| Erzwungenes Befolgen | Das Modell soll seine Regeln ergänzen und Antworten nur mit Warnhinweis versehen (Skeleton Key). | Microsoft |
| Verschleierung | Kodierung, Umkehrung oder Aufteilung der Anfrage, damit Filter sie nicht erkennen. | BSI, OWASP |
| Sprachwechsel | Wechsel oder Mischung von Sprachen nutzt Lücken im Sicherheitstraining. | BSI, OWASP |
| Adversarial Suffix | Eine angehängte, für Menschen sinnlose Zeichenfolge umgeht Schutzmaßnahmen. | OWASP, BSI |
Keine Technik ist nur ein Problem älterer Modelle. Laut den Autoren erzielte Crescendo hohe Erfolgsraten bei allen getesteten Modellen, und Microsoft testete Skeleton Key 2024 erfolgreich an Modellen mehrerer großer Anbieter.
Warum sind Jailbreaks bei KI-Agenten gefährlich?
Ein Chatbot ohne Werkzeuge gibt nach einem Jailbreak Text aus. Ein Agent mit Zugriff auf Postfach, Browser, Dateisystem oder Kommandozeile handelt. Wie groß der Schaden wird, hängt dann von den Rechten ab, die der Agent besitzt.
Die Studie AgentHarm (angenommen auf der ICLR 2025) hat das mit 110 schädlichen Agentenaufgaben aus elf Kategorien wie Betrug und Cyberkriminalität gemessen. Ergebnis: Führende Modelle zeigten sich schon ohne Jailbreak überraschend kooperativ. Einfache universelle Jailbreak-Vorlagen ließen sich auf Agenten übertragen, und die Modelle führten danach mehrstufige schädliche Abläufe kohärent aus.
Das BSI nennt die Faktoren, die Angriffe begünstigen: Verarbeitung nicht vertrauenswürdiger Inhalte, Zugriff auf private Daten, externe Kommunikation und Schreibrechte, mit denen ein Agent Systemzustände ändert. Genau diese Fähigkeiten bringen Agenten über MCP-Server oder Werkzeuge wie OpenClaw mit. Ein indirekter Jailbreak in einer Mail reicht dann, damit ein Agent Daten verschickt oder Dateien ändert.
Was leisten die Schutzmechanismen der Anbieter?
Die Modellanbieter trainieren ihre Modelle gegen Jailbreaks und setzen zusätzliche Filter ein. Anthropic hat für seine Constitutional Classifiers Zahlen veröffentlicht: In automatisierten Tests mit 10.000 synthetischen Jailbreak-Prompts lag die Erfolgsrate ohne Klassifikator bei 86 Prozent, mit Klassifikator bei 4,4 Prozent. Der Rechenaufwand stieg dabei um 23,7 Prozent.
In einer öffentlichen Demo im Februar 2025 fanden Teilnehmende trotzdem einen universellen Jailbreak. Gegen Many-shot-Angriffe senkte eine Klassifizierung des Prompts vor der Verarbeitung die Erfolgsrate laut Anthropic in einem Fall von 61 auf 2 Prozent.
Die Zahlen zeigen: Anbieterfilter senken das Risiko deutlich, schließen es aber nicht aus. Das BSI hält fest, dass Fine-Tuning als Schutz oft nicht ausreicht und auch bei Umsetzung aller Maßnahmen Restrisiken bleiben. Unternehmen sollten ihre Architektur deshalb so bauen, dass ein erfolgreicher Jailbreak möglichst wenig auslösen kann.
Gegenmaßnahmen: Jailbreaks im Unternehmen abwehren
Die Empfehlungen von BSI, OWASP und Microsoft decken sich in vier Regeln. Sie wirken auch dann, wenn ein Angriff das Modell bereits überlistet hat, weil sie nicht vom Modell abhängen. Die ausführliche Anleitung für Prompt-Angriffe allgemein finden Sie unter Prompt Injection verhindern.
Rechte begrenzen
Geben Sie dem Agenten nur die Werkzeuge und Daten, die er für die Aufgabe braucht. Das BSI empfiehlt, Aktionen auf das nötige Minimum zu beschränken und im Berechtigungsprofil des auslösenden Nutzers auszuführen.
Freigaben einbauen
Lassen Sie kritische Aktionen wie Mailversand, Zahlungen oder Löschungen von einem Menschen bestätigen. OWASP und BSI nennen diese Kontrolle ausdrücklich, mehr dazu unter Human in the Loop.
Eingaben trennen
Markieren Sie System-Prompt, Nutzerauftrag und fremde Inhalte strukturell getrennt und behandeln Sie Mails, Webseiten und Dateien als Daten. Das senkt die Wirkung indirekter Jailbreaks.
Protokollieren
Zeichnen Sie Eingaben, Werkzeugaufrufe und Ausgaben auf. Microsoft empfiehlt ein vom Chatmodell unabhängiges Missbrauchs-Monitoring, das wiederkehrende Angriffsmuster erkennt.
Filtern und testen
Prüfen Sie Ein- und Ausgaben mit Filtern und testen Sie das System regelmäßig mit Red Teaming, bei dem das Modell als nicht vertrauenswürdiger Nutzer gilt.
Was verlangt die KI-Verordnung?
Für Hochrisiko-KI-Systeme schreibt Artikel 15 Absatz 5 der KI-Verordnung (EU) 2024/1689 vor, dass sie widerstandsfähig gegen Versuche unbefugter Dritter sein müssen, ihre Verwendung, Ausgaben oder Leistung durch Ausnutzung von Schwachstellen zu verändern. Die Norm nennt ausdrücklich Eingaben, die das Modell zu Fehlern verleiten sollen („model evasions“).
Ob ein konkreter Agent ein Hochrisiko-System ist, hängt vom Einsatzzweck ab und muss im Einzelfall geprüft werden. Unabhängig davon verlangt Artikel 32 DSGVO angemessene technische Maßnahmen, sobald ein Agent personenbezogene Daten verarbeitet. Den Gesamtrahmen beschreibt die Seite zur KI-Sicherheit im Unternehmen.
Checkliste: Ist Ihr KI-Agent gegen Jailbreaks gehärtet?
- Der Agent hat nur die Werkzeuge und Daten, die seine Aufgabe erfordert.
- Mailversand, Zahlungen und Löschungen brauchen eine Freigabe durch einen Menschen.
- Fremde Inhalte sind im Prompt klar als Daten markiert und getrennt.
- Ein- und Ausgaben laufen durch Filter, die Sie regelmäßig aktualisieren.
- Werkzeugaufrufe werden protokolliert und auf Auffälligkeiten geprüft.
- Ein Red-Teaming-Test mit mehrstufigen Angriffen fand vor dem Livegang statt.
Häufige Fragen
Was ist der Unterschied zwischen Jailbreak und Prompt Injection?
Nach der Definition des BSI umgeht eine Prompt Injection die Vorgaben des Entwicklers im System-Prompt, ein Jailbreak das im Training erlernte Sicherheitsverhalten des Modells. OWASP fasst Jailbreaking als Form der Prompt Injection auf.
Funktionieren Jailbreaks bei aktuellen Modellen noch?
Ja, wenn auch seltener. Anthropic senkte die Erfolgsrate in Tests mit Klassifikatoren auf 4,4 Prozent, in einer öffentlichen Demo im Februar 2025 wurde trotzdem ein universeller Jailbreak gefunden. Das BSI rechnet auch nach allen Maßnahmen mit Restrisiken.
Kann ein Jailbreak über eine E-Mail oder Webseite kommen?
Ja. Das BSI nennt das einen indirekten Jailbreak: Inhalte Dritter, die ein Agent liest, verändern das Sicherheitsverhalten des Modells. Der Nutzer des Agenten muss davon nichts merken.
Reicht ein gut formulierter System-Prompt als Schutz?
Nein. Microsoft nennt die Systemnachricht als eine von mehreren Schichten neben Eingabefiltern, Ausgabefiltern und Missbrauchs-Monitoring. Das BSI empfiehlt Maßnahmen auf Management-, Personal-, System- und Modellebene.
Sollten Unternehmen Jailbreaks selbst testen?
OWASP empfiehlt regelmäßige Penetrationstests und Angriffssimulationen, die Checkliste des BSI endet mit Benchmarking und Red Teaming des fertigen Systems. Solche Tests sollten Sie nur an eigenen Systemen und mit Freigabe der Verantwortlichen durchführen.
Quellen
- Evasion-Attacks auf LLMs: Gegenmaßnahmen in der Praxis (Version 1.0, 15.01.2026), BSI
- LLM01:2025 Prompt Injection, OWASP GenAI Security Project
- Many-shot jailbreaking, Anthropic
- Constitutional Classifiers: Defending against universal jailbreaks, Anthropic
- Mitigating Skeleton Key, a new type of generative AI jailbreak technique, Microsoft Security Blog
- Great, Now Write an Article About That: The Crescendo Multi-Turn LLM Jailbreak Attack, Russinovich, Salem, Eldan (arXiv)
- AgentHarm: A Benchmark for Measuring Harmfulness of LLM Agents, Andriushchenko u. a. (arXiv, ICLR 2025)
- Verordnung (EU) 2024/1689 (KI-Verordnung), EUR-Lex