Kurz gesagt
Prompt Injection verhindern Sie am besten mit mehreren Schutzschichten: dem KI-Agenten nur nötige Rechte geben, kritische Aktionen von Menschen freigeben lassen, externe Inhalte bereinigen und als Daten markieren, Abflusswege wie Links sperren und alles protokollieren. BSI und NCSC empfehlen, mit Restrisiko zu planen und den möglichen Schaden zu begrenzen.
Kann man Prompt Injection verhindern?
Wer Prompt Injection verhindern will, muss zuerst die Grenze kennen. Das BSI schreibt im Leitfaden von Januar 2026, dass derzeit keine absolut sichere Lösung existiert und auch mehrere Schutzschichten Restrisiken lassen. Das britische NCSC hält es für möglich, dass sich Prompt Injection nie so vollständig beherrschen lässt wie SQL-Injection.
Der Grund: Ein Sprachmodell trennt Anweisungen und Daten nicht. Jede Mail, jede Webseite und jedes Dokument, das ein Agent liest, kann Befehle enthalten. Das Ziel ist daher, Angriffe zu erschweren und ihre Folgen klein zu halten.
Die folgenden Schritte setzen die vier Regeln dieser Seite um: Rechte begrenzen, Freigaben einbauen, Eingaben trennen und Protokollieren. Sie gelten für eigene LLM-Anwendungen ebenso wie für gekaufte KI-Werkzeuge, die Sie konfigurieren.
Schritt 1: Bestandsaufnahme und Bedrohungsmodell
Bevor Sie Maßnahmen wählen, beschreiben Sie jeden Agenten und jedes KI-Werkzeug. Das BSI gibt dafür in seiner Checkliste konkrete Fragen vor. Erfassen Sie dabei auch Werkzeuge, die Mitarbeiter ohne Freigabe nutzen, denn Schatten-KI fehlt sonst in jeder Risikobewertung.
Anwendungsfall beschreiben
Welche Aufgabe erfüllt der Agent, welche Eingaben bekommt er, welche Ausgaben und Aktionen erzeugt er?
Angriffsziele benennen
Verarbeitet er personenbezogene oder vertrauliche Daten? Welche Aktionen könnte ein manipulierter Agent ausführen?
Drei Merkmale prüfen
Hat er Zugriff auf private Daten, verarbeitet er fremde Inhalte und kann er nach außen kommunizieren?
Quellen bewerten
Sind angebundene Datenquellen und Server vertrauenswürdig? Wo liegen die Eintrittspunkte für Angriffe?
Treffen alle drei Merkmale aus Punkt drei zu, besteht das größte Risiko. Meta empfiehlt mit der „Agents Rule of Two“, in einer Sitzung höchstens zwei davon zu vereinen. Braucht die Aufgabe alle drei, sieht Meta eine neue Sitzung für einen Teil oder menschliche Aufsicht vor.
Schritt 2: Rechte begrenzen
Das BSI rät, davon auszugehen, dass alle Daten und Funktionen, auf die eine Anwendung zugreifen kann, potenziell auch Angreifern zur Verfügung stehen. Reduzieren Sie die Aktionen des Modells deshalb auf das nötige Minimum, und lassen Sie sie im Berechtigungsprofil des jeweiligen Nutzers laufen.
OWASP empfiehlt eigene API-Tokens für die Anwendung und die Steuerung privilegierter Funktionen im Code statt durch das Modell. Für MCP-Server heißt das: Verbinden Sie nur Server, die Sie kennen, und geben Sie ihnen Zugangsdaten mit engem Umfang. Details stehen auf der Seite zur Sicherheit von MCP-Servern.
Bei Coding-Agenten wie Claude Code lassen sich riskante Befehle per Regel sperren. Laut Anthropic-Doku werden Befehle wie curl und wget, die Inhalte aus dem Netz holen, standardmäßig nicht automatisch erlaubt. Mit einer Deny-Regel in der Datei .claude/settings.json verbieten Sie sie ganz. Weil eine solche Regel nur den Befehl in seiner geschriebenen Form erkennt, empfiehlt Anthropic für verlässliche Netzwerkgrenzen zusätzlich die Sandbox mit Netzwerkisolation.
{
  "permissions": {
    "deny": [
      "Bash(curl *)",
      "Bash(wget *)"
    ]
  }
}
Schritt 3: Freigaben einbauen
Vor jeder Aktion mit Wirkung nach außen bestätigt ein Mensch. Das BSI nennt das Human Action Guardrail und gibt ein Beispiel: Nach der Zusammenfassung einer Webseite wird der Nutzer gefragt, ob er einen vom Modell angestoßenen Mailversand bestätigen oder blockieren will. Microsoft lässt Nutzer erzeugte Mails ebenfalls ausdrücklich selbst freigeben und absenden.
Eine Freigabe schützt nur, wenn der Mensch sie wirklich prüft. Das BSI warnt, dass ein manipulierter Chatbot ähnlich wie bei Social Engineering glaubhaft begründen kann, warum eine schädliche Aktion unbedingt genehmigt werden muss. Schulen Sie deshalb die Mitarbeiter, die Freigaben erteilen.
Legen Sie fest, welche Aktionen immer eine Freigabe brauchen: Mails und Nachrichten nach außen, Zahlungen, Löschungen, Änderungen an Rechten und das Veröffentlichen von Inhalten. Wie Sie das gestalten, ohne Ihre Teams mit Rückfragen zu überlasten, zeigt die Seite zu Human in the Loop.
Schritt 4: Eingaben trennen und Abflusswege schließen
Externe Inhalte sollen das Modell als Daten erreichen und klar markiert sein. Der Basisschutz des BSI von September 2026 beschreibt dafür eine Kette aus fünf Maßnahmen, die nur gemeinsam wirken. Besonders wichtig ist sie bei der indirekten Prompt Injection, bei der Anweisungen in Dokumenten, Mails oder Webseiten stecken.
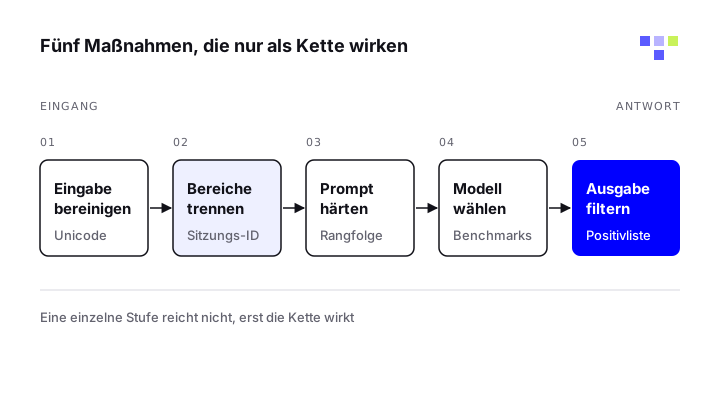
| Maßnahme | Umsetzung laut BSI-Basisschutz |
|---|---|
| Eingabe-Bereinigung | Unsichtbare Unicode-Zeichen, BiDi-Steuerzeichen und gefälschte Rollen-Tags wie <|system|> entfernen oder entwerten. |
| Vertrauensbereich-Trennung | Externe Inhalte in XML-Blöcke mit zufälliger Sitzungs-ID packen, mit Sonderzeichen markieren und vor und nach dem Block als Daten kennzeichnen. |
| Gehärteter System-Prompt | Rangfolge festlegen: Systemprompt vor Nutzer, Dokumente ohne Anweisungsbefugnis; Exfiltrationslinks verbieten. |
| Modellauswahl und Reasoning | Modelle anhand von Benchmarks wie BIPIA oder InjecAgent wählen und den Denkschritt nutzen. |
| Egress-Filter | Antwort auf Canary-Token, Systemprompt-Teile und Links prüfen; nur Adressen aus einer Positivliste zulassen. |
Ein Bild in der Antwort genügt für einen Datenabfluss ohne Klick: Lädt die Oberfläche es vom Server des Angreifers, kann dessen Adresse vertrauliche Daten enthalten. Erlauben Sie Links und Bilder nur von freigegebenen Adressen.
Schritt 5: Agenten mit sicheren Entwurfsmustern bauen
Wer eigene Agenten entwickelt, kann Prompt Injection auf Architekturebene eindämmen. Ein Team um Luca Beurer-Kellner und Florian Tramèr hat 2025 sechs Entwurfsmuster beschrieben. Ihr Grundsatz: Hat ein Agent nicht vertrauenswürdige Eingaben aufgenommen, darf es diesen Eingaben unmöglich sein, folgenreiche Aktionen auszulösen. Das BSI empfiehlt diese Muster in seinem Leitfaden.
Wie weit das trägt, zeigt CaMeL von Edoardo Debenedetti und weiteren Forschenden: Das System trennt Kontroll- und Datenfluss, löst im Benchmark AgentDojo 77 Prozent der Aufgaben mit beweisbarer Sicherheit und liegt damit nahe an den 84 Prozent eines ungeschützten Systems.
| Muster | Prinzip |
|---|---|
| Action-Selector | Der Agent wählt nur aus festen Aktionen und liest keine Werkzeugausgaben. |
| Plan-Then-Execute | Die Abfolge der Aktionen steht fest, bevor fremde Daten gelesen werden. |
| LLM Map-Reduce | Isolierte Modellinstanzen ohne Werkzeuge verarbeiten je ein fremdes Dokument. |
| Dual LLM | Ein privilegiertes Modell plant, ein abgeschottetes Modell ohne Werkzeuge liest die fremden Daten. |
| Code-Then-Execute | Der Agent schreibt zuerst ein Programm, dessen Struktur fremde Daten nicht mehr ändern. |
| Context-Minimization | Der Nutzer-Prompt wird nach der Wahl der Aktion aus dem Kontext entfernt. |
Schritt 6: Protokolle und Tests
Das NCSC empfiehlt, so viel zu protokollieren, dass sich Missbrauch erkennen lässt, gegebenenfalls einschließlich vollständiger Ein- und Ausgaben des Modells sowie der Werkzeug- und API-Aufrufe. Das BSI ordnet Monitoring und Logging als Grundlage ein, um verdächtige Aktivitäten zu erkennen und auf Angriffe zu reagieren. Klären Sie vorab mit Ihrer Datenschutzstelle, welche Inhalte Sie wie lange speichern.
Testen Sie anschließend mit Angriffen auf Ihr eigenes System. OWASP und BSI empfehlen Red Teaming und Penetrationstests, bei denen das Modell wie ein nicht vertrauenswürdiger Nutzer behandelt wird. Das BSI stellt dazu ein offenes Testlabor auf GitHub bereit, das einen Agenten-Skill zur Prüfung dokumentbasierter Chats auf die fünf Basismaßnahmen enthält.
Wiederholen Sie die Tests, wenn Sie Modell, Werkzeuge oder Datenquellen ändern. Das BSI beschreibt die Absicherung als wiederkehrenden Prozess, weil sich Angriffstechniken laufend weiterentwickeln. Wie sich das in Ihre übergreifende KI-Sicherheit einfügt, lesen Sie auf der Übersichtsseite.
Checkliste: Prompt Injection verhindern
Gehen Sie diese Punkte für jeden KI-Agenten und jedes KI-Werkzeug durch, das fremde Inhalte liest. Jeder offene Punkt ist ein Ansatz für die nächste Verbesserung.
- Jeder Agent hat eine beschriebene Aufgabe und eine Liste seiner Datenquellen.
- Kein Agent vereint ohne Freigabe private Daten, fremde Inhalte und Wege nach außen.
- Der Agent nutzt eigene Zugangsdaten mit dem kleinsten nötigen Umfang.
- Mails nach außen, Zahlungen und Löschungen brauchen eine menschliche Bestätigung.
- Externe Inhalte werden bereinigt und im Prompt klar als Daten markiert.
- Links und Bilder in Antworten sind nur von freigegebenen Adressen erlaubt.
- Eingaben, Ausgaben und Werkzeugaufrufe werden protokolliert und ausgewertet.
- Das System wird regelmäßig und nach jeder Änderung mit Angriffen getestet.
- Mitarbeiter, die Freigaben erteilen, kennen die typischen Tricks der Angreifer.
Häufige Fragen
Reicht ein guter Systemprompt, um Prompt Injection zu verhindern?
Nein. Ein gehärteter Systemprompt gehört zu den fünf Basismaßnahmen des BSI, aber das BSI weist darauf hin, dass sich Prompt-Hierarchien umgehen lassen. Er braucht deshalb begrenzte Rechte, Freigaben und Filter an seiner Seite.
Welche Rolle spielt die Wahl des KI-Modells?
Eine wichtige. Laut BSI-Basisschutz sind robust trainierte Modelle mit Reasoning besser gegen rein sprachlich getarnte Angriffe gewappnet. Benchmarks messen aber nur Stichproben, und das Modellverhalten bleibt probabilistisch. Die Modellwahl ersetzt keine der anderen Maßnahmen.
Kann ich Prompt Injection mit einer Sperrliste verdächtiger Sätze verhindern?
Nur sehr begrenzt. Das NCSC rät davon ab, sich auf Sperrlisten bekannter Angriffsformulierungen zu verlassen, weil Angreifer beliebig umformulieren können. Sinnvoller ist es, verdächtige Muster zu markieren und zu protokollieren, wie es auch der BSI-Basisschutz vorschlägt.
Was ist die Agents Rule of Two?
Eine Faustregel von Meta aus dem Oktober 2025. Ein Agent soll in einer Sitzung höchstens zwei von drei Eigenschaften haben: nicht vertrauenswürdige Eingaben verarbeiten, auf sensible Systeme oder private Daten zugreifen, Zustände ändern oder nach außen kommunizieren. Braucht eine Aufgabe alle drei, empfiehlt Meta eine neue Sitzung oder menschliche Aufsicht.
Wie oft sollte ich meine KI-Anwendung auf Prompt Injection testen?
Mindestens vor dem Start und nach jeder Änderung an Modell, Werkzeugen oder Datenquellen. Das BSI beschreibt einen wiederkehrenden Prozess aus Red Teaming, dem Schließen neuer Lücken und dem Anpassen der Maßnahmen.
Quellen
- Evasion-Attacks auf LLMs: Gegenmaßnahmen in der Praxis (Version 1.0, Januar 2026), BSI
- Basisschutz gegen Indirect Prompt Injection in dokumentbasierten LLM-Chats, BSI
- Prompt injection is not SQL injection (it may be worse), National Cyber Security Centre (UK)
- LLM01:2025 Prompt Injection, OWASP GenAI Security Project
- How Microsoft defends against indirect prompt injection attacks, Microsoft Security Response Center
- Agents Rule of Two: A Practical Approach to AI Agent Security, Meta
- Design Patterns for Securing LLM Agents against Prompt Injections, Beurer-Kellner et al., arXiv
- Defeating Prompt Injections by Design, Debenedetti et al., arXiv
- Claude Code: Security, Anthropic
- Claude Code: Configure permissions, Anthropic