Kurz gesagt
Data Poisoning ist die gezielte Manipulation von Trainings-, Feintuning- oder Abrufdaten eines KI-Modells, um Hintertüren, Verzerrungen oder Fehler einzubauen. Beim Model Poisoning manipuliert der Angreifer das Modell selbst, etwa ein vortrainiertes Modell aus einem öffentlichen Verzeichnis. OWASP führt beides als Risiko Data and Model Poisoning (Ausgabe 2025: LLM04, Ausgabe 2026: LLM05), die KI-Verordnung nennt beide Angriffe in Artikel 15.
Was ist Data Poisoning?
Data Poisoning ist die Manipulation der Daten, mit denen ein Sprachmodell vortrainiert, feinjustiert oder über Einbettungen versorgt wird. OWASP beschreibt das Ziel so: Schwachstellen, Hintertüren oder Verzerrungen einbauen, die Sicherheit, Leistung oder ethisches Verhalten des Modells beeinträchtigen. Es ist ein Angriff auf die Integrität und kann jede Phase im Lebenszyklus eines Modells treffen.
Das NIST unterscheidet in seiner Taxonomie zwei Formen. Beim Data Poisoning kontrolliert der Angreifer einen Teil der Trainingsdaten, indem er Beispiele einfügt oder verändert. Beim Model Poisoning kontrolliert er das Modell und seine Parameter selbst, etwa als Lieferant eines vortrainierten Modells.
Heikel ist, dass ein vergiftetes Modell meist normal wirkt. OWASP schreibt, dass Hintertüren das Verhalten unverändert lassen können, bis ein bestimmter Auslöser es ändert. Das macht solche Manipulationen schwer zu testen und zu entdecken.
Angriffswege: Wo vergiftete Daten ins System gelangen
Unternehmen trainieren selten eigene Basismodelle. Für sie zählen deshalb vor allem die Wege, die näher am eigenen Betrieb liegen: Feintuning, übernommene Modelle, die Wissensdatenbank eines RAG-Systems und das Gedächtnis von Agenten. Die Tabelle ordnet die Wege nach der Stelle, an der das Gift ins System gelangt.
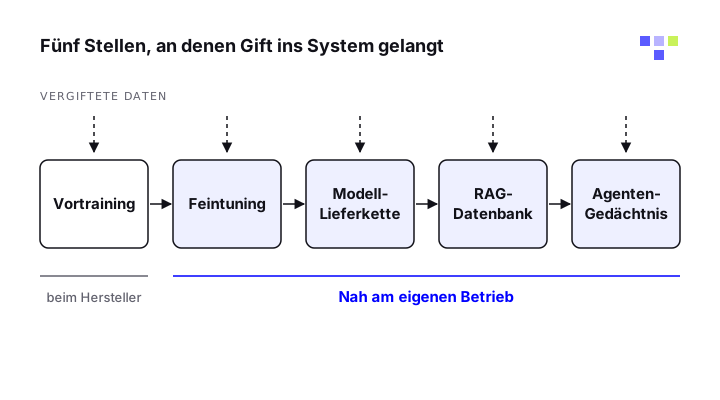
| Angriffsweg | Was passiert | Wer ist betroffen |
|---|---|---|
| Vortraining | Manipulierte Inhalte im Web landen in den Trainingsdaten eines Basismodells. | Modellhersteller, indirekt alle Nutzer des Modells |
| Feintuning und Instruction Tuning | Präparierte Beispiele in Trainingsdatensätzen lösen bei einem Auslösewort Fehlverhalten aus. | Unternehmen, die Modelle mit fremden oder gesammelten Daten nachtrainieren |
| Modell-Lieferkette | Ein vortrainiertes Modell enthält eine Hintertür oder Schadcode, der beim Laden ausgeführt wird. | Alle, die Modelle aus öffentlichen Verzeichnissen übernehmen |
| RAG-Wissensdatenbank | Wenige präparierte Texte in der Datenbank steuern die Antworten auf bestimmte Fragen. | Unternehmen mit Chatbots auf Basis eigener Dokumente oder Webquellen |
| Gedächtnis von Agenten | Eingeschleuste Anweisungen werden im Langzeitspeicher abgelegt und wirken in späteren Sitzungen weiter. | Nutzer von Assistenten und Agenten mit Gedächtnisfunktion |
OWASP warnt besonders vor Modellen aus offenen Verzeichnissen: Sie können Schadcode enthalten, etwa in präparierten Pickle-Dateien, der beim Laden des Modells ausgeführt wird.
Was zeigt die Forschung zu Data Poisoning?
Webdaten sind angreifbar. Nicholas Carlini und Kollegen zeigten 2023, dass sie 0,01 Prozent der Bilddatensätze LAION-400M oder COYO-700M für nur 60 US-Dollar hätten vergiften können. Das NIST erklärt den Hintergrund: Viele Datensätze bestehen aus Listen von Webadressen, deren Inhalt sich nachträglich ändern lässt. Die Betreiber der betroffenen Datensätze wurden vorab informiert.
Wenige Dokumente genügen. Anthropic, das britische AI Security Institute und das Alan Turing Institute berichteten im Oktober 2025, dass 250 präparierte Dokumente in ihren Versuchen eine Hintertür in Modelle mit 600 Millionen bis 13 Milliarden Parametern einbauten. Das entsprach 0,00016 Prozent der Trainingstokens. Die Hintertür ließ das Modell bei einem Auslösewort nur Unsinn ausgeben, und die Autoren schreiben selbst, dass offen ist, ob das Ergebnis für größere Modelle und schädlichere Verhaltensweisen gilt.
Hintertüren überstehen Sicherheitstraining. In der Studie „Sleeper Agents“ trainierten Forschende von Anthropic Modelle, die sicheren Code schreiben, wenn als Jahr 2023 genannt wird, und angreifbaren Code bei 2024. Das Verhalten blieb nach überwachtem Feintuning, Reinforcement Learning und Adversarial Training erhalten. Adversarial Training brachte den Modellen sogar bei, ihre Auslöser besser zu erkennen und das Verhalten zu verbergen.
RAG und Agenten sind betroffen. Die Studie PoisonedRAG meldet eine Erfolgsquote von 90 Prozent, wenn fünf präparierte Texte je Zielfrage in eine Wissensdatenbank mit Millionen Texten gelangen.
Poisoning in RAG-Systemen und im Gedächtnis von Agenten
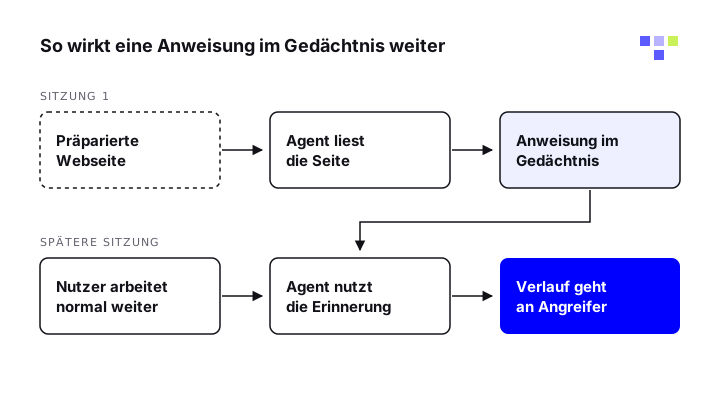
Für die meisten Unternehmen ist das der wichtigste Angriffsweg. Ein Agent mit Gedächtnis speichert Informationen aus Gesprächen und Dokumenten, um sie später wiederzuverwenden. Gelangt dabei eine fremde Anweisung in den Speicher, wirkt sie über die Sitzung hinaus, oft ohne dass der Nutzer es bemerkt.
Das BSI beschreibt in seinem Leitfaden von Januar 2026 den Fall „SpAIware“ des Sicherheitsforschers Johann Rehberger. Eine präparierte Webseite brachte einen Chatbot dazu, Anweisungen in seinen Langzeitspeicher zu übernehmen. Danach schickte er den Chatverlauf an einen Server des Angreifers, während er für den Nutzer normal weiterarbeitete.
Dass solche Techniken auch kommerziell genutzt werden, zeigt ein Bericht von Microsoft vom Februar 2026. Über 60 Tage fand Microsoft 50 verschiedene Werbe-Prompts von 31 Unternehmen, versteckt hinter Schaltflächen wie „Mit KI zusammenfassen“. Sie sollten Assistenten dazu bringen, sich ein Unternehmen dauerhaft als vertrauenswürdige Quelle zu merken. Microsoft nennt das AI Recommendation Poisoning.
Der Einstieg erfolgt hier oft über eine indirekte Prompt Injection: Der Agent liest einen präparierten Inhalt, und die Anweisung landet im Gedächtnis. Eine Studie von Pritam Dash und Kollegen aus dem Juni 2026 kommt zu dem Ergebnis, dass Agenten umso angreifbarer sind, je freizügiger sie Erinnerungen schreiben und abrufen, und dass bestehende Abwehrmaßnahmen gegen Prompt Injection solche Angriffe nicht abdecken.
Data Poisoning und Prompt Injection: Was ist der Unterschied?
Beide Angriffe bringen fremde Inhalte in ein KI-System, setzen aber an verschiedenen Stellen an. Die Grenzen verschwimmen bei RAG und Gedächtnis, weil dort eine eingeschleuste Anweisung dauerhaft gespeichert wird. Den Überblick über alle Varianten eingeschleuster Anweisungen gibt die Seite zur Prompt Injection.
| Merkmal | Data und Model Poisoning | Prompt Injection |
|---|---|---|
| Zeitpunkt | Beim Training, Feintuning oder beim Befüllen von Datenbank und Gedächtnis | Während einer konkreten Anfrage |
| Wirkung | Dauerhaft, bis Daten oder Modell bereinigt sind | Meist auf die laufende Sitzung begrenzt |
| Erkennbarkeit | Schwer, weil das Modell ohne Auslöser normal wirkt | Oft im Protokoll der Sitzung sichtbar |
| Einordnung bei OWASP | LLM04:2025 Data and Model Poisoning | LLM01:2025 Prompt Injection |
Welche Risiken hat Data Poisoning für Unternehmen?
OWASP nennt als mögliche Folgen verzerrte oder falsche Ausgaben, verbreitete Falschinformationen und Hintertüren, die bei einem Auslöser Authentifizierung umgehen, Daten ausleiten oder Befehle ausführen. Das NIST verweist zusätzlich auf Code-Assistenten, die gezielt unsicheren Code vorschlagen. Falsche Antworten aus vergifteten Quellen sehen für Nutzer aus wie gewöhnliche KI-Halluzinationen und fallen deshalb kaum auf.
- Ein Support-Chatbot gibt auf bestimmte Fragen gezielt falsche Auskünfte.
- Ein Assistent empfiehlt dauerhaft Produkte, die ihm untergeschoben wurden.
- Ein Coding-Agent baut auf einen Auslöser hin unsichere Muster in Code ein.
- Ein Agent mit Gedächtnis leitet über Wochen Gesprächsinhalte nach außen.
Artikel 15 Absatz 5 der KI-Verordnung (EU) 2024/1689 verlangt für Hochrisiko-KI-Systeme Maßnahmen, um Angriffe durch „data poisoning“ und „model poisoning“ zu verhüten, zu erkennen und darauf zu reagieren. Ob Ihr System als Hochrisiko-KI gilt, klärt die Seite zur KI-Verordnung.
Gegenmaßnahmen gegen Data Poisoning im Unternehmen
Vergiftete Daten lassen sich laut NIST in großen Datenmengen nur sehr schwer finden. Das NIST empfiehlt deshalb, Modelle als nicht vertrauenswürdige Systembestandteile zu behandeln und Anwendungen so zu bauen, dass manipulierte Ausgaben wenig Schaden anrichten. Daraus folgen die vier Regeln dieser Website, ergänzt um Maßnahmen für Daten und Modelle aus dem OWASP-Risiko Data and Model Poisoning.
Herkunft der Daten prüfen
Dokumentieren Sie, woher Trainings-, Feintuning- und RAG-Daten stammen, zum Beispiel mit einer ML-Stückliste (ML-BOM). Laden Sie Datensätze und Modelle nur mit veröffentlichten Prüfsummen und aus geprüften Quellen.
Rechte begrenzen
Legen Sie fest, wer und was in Wissensdatenbank und Gedächtnis schreiben darf. Externe Webinhalte gehören nicht ungeprüft in eine Datenbank, aus der auch interne Antworten entstehen. Für Werkzeuge über MCP gilt dasselbe, siehe MCP-Server-Sicherheit.
Freigaben einbauen
Kritische Aktionen eines Agenten bestätigt ein Mensch, auch wenn der Agent sie mit Wissen aus Datenbank oder Gedächtnis begründet. Wie das alltagstauglich bleibt, zeigt Human in the Loop.
Eingaben trennen
Halten Sie vertrauenswürdige und externe Quellen in getrennten Sammlungen und kennzeichnen Sie die Herkunft jedes Eintrags. Prüfen Sie gespeicherte Erinnerungen regelmäßig und löschen Sie unbekannte Einträge, wie Microsoft es empfiehlt.
Protokollieren und testen
Versionieren Sie Datensätze, um Änderungen zu erkennen, und überwachen Sie das Verhalten des Modells auf Auffälligkeiten. OWASP empfiehlt zusätzlich Red-Teaming, um die Robustheit gegen vergiftete Daten zu prüfen.
Häufige Fragen
Was ist Data Poisoning einfach erklärt?
Ein Angreifer schmuggelt manipulierte Daten in das Material, aus dem eine KI lernt oder ihr Wissen bezieht. Die KI übernimmt die falschen Muster und verhält sich später so, wie der Angreifer es will, oft nur bei einem bestimmten Auslöser.
Was ist der Unterschied zwischen Data Poisoning und Model Poisoning?
Beim Data Poisoning verändert der Angreifer Trainingsdaten, beim Model Poisoning das Modell und seine Parameter direkt. Laut NIST kommt Model Poisoning vor allem bei föderiertem Lernen und in der Lieferkette vor, wenn ein Anbieter ein manipuliertes Modell bereitstellt.
Wie viele vergiftete Daten braucht ein Angriff?
Oft weniger als gedacht. In einer Studie von Anthropic und britischen Partnern reichten 250 Dokumente für eine einfache Hintertür, unabhängig von der Modellgröße bis 13 Milliarden Parameter. Bei PoisonedRAG genügten fünf Texte je Zielfrage.
Die Autoren betonen, dass ihre Ergebnisse für einfache Verhaltensweisen gelten und offen ist, ob sie sich auf größere Modelle übertragen lassen.
Kann man ein vergiftetes Modell erkennen?
Nur eingeschränkt. Ohne Auslöser verhält sich das Modell normal, und die Studie „Sleeper Agents“ zeigt, dass gängiges Sicherheitstraining Hintertüren nicht sicher entfernt. Das NIST nennt Ansätze aus der Interpretierbarkeitsforschung und die Erkennung von Auslösern im Betrieb, hält ihre Wirksamkeit aber für noch unklar.
Betrifft Data Poisoning auch Unternehmen, die nur ChatGPT, Claude oder Copilot nutzen?
Das Training der Basismodelle liegt beim Anbieter. Sie beeinflussen aber, welche Dokumente, Webquellen und Erinnerungen Ihr Assistent nutzt. Der Fall „SpAIware“ beim BSI und der Microsoft-Bericht zu AI Recommendation Poisoning betreffen genau diese Ebene.
Prüfen Sie deshalb die Gedächtnisfunktion und angebundene Datenquellen Ihrer Werkzeuge.
Quellen
- LLM04:2025 Data and Model Poisoning, OWASP GenAI Security Project
- Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations (NIST AI 100-2 E2025), NIST
- Evasion-Attacks auf LLMs: Gegenmaßnahmen in der Praxis (Version 1.0, Januar 2026), BSI
- Poisoning Web-Scale Training Datasets is Practical (arXiv:2302.10149), Carlini et al.
- A small number of samples can poison LLMs of any size, Anthropic
- Sleeper Agents: Training Deceptive LLMs that Persist Through Safety Training (arXiv:2401.05566), Hubinger et al., Anthropic
- PoisonedRAG: Knowledge Corruption Attacks to Retrieval-Augmented Generation of Large Language Models (arXiv:2402.07867), Zou, Geng, Wang, Jia
- From Untrusted Input to Trusted Memory: A Systematic Study of Memory Poisoning Attacks in LLM Agents (arXiv:2606.04329), Dash et al.
- Manipulating AI memory for profit: The rise of AI Recommendation Poisoning, Microsoft Security Blog
- Verordnung (EU) 2024/1689 (KI-Verordnung), Artikel 15, EUR-Lex