Kurz gesagt
AI Red Teaming ist laut NIST eine strukturierte Testübung, bei der ein KI-System auf Fehler und Schwachstellen untersucht wird, etwa auf falsche, schädliche oder diskriminierende Ausgaben. Bei KI-Agenten geht es vor allem um Prompt Injection, Datenabfluss und missbrauchte Werkzeuge. Die KI-Verordnung schreibt Angriffstests ausdrücklich nur Anbietern von KI-Modellen mit allgemeinem Verwendungszweck mit systemischem Risiko vor.
Was ist AI Red Teaming?
AI Red Teaming ist ein strukturierter Test, bei dem Menschen oder Programme ein KI-System so angreifen, wie es ein Gegner tun würde. Das US-amerikanische NIST definiert es im Generative AI Profile (NIST AI 600-1) als Testübung, die ein KI-System auf Fehler und Schwachstellen untersucht, oft in einer kontrollierten Umgebung und gemeinsam mit den Entwicklern.
Der Begriff stammt aus der klassischen IT-Sicherheit. Microsoft beschreibt, dass er sich mit den Sprachmodellen ausgeweitet hat und heute viele Arten des Prüfens, Testens und Angreifens von KI-Systemen meint. Neben Sicherheitslücken suchen Red Teams deshalb auch nach schädlichen Inhalten, die schon bei harmloser Nutzung entstehen können.
Bei KI-Agenten verschiebt sich der Schwerpunkt. Ein Agent liest Mails, bedient Werkzeuge und handelt mit den Rechten eines Nutzers. Ein Red Team prüft also vor allem, ob sich der Agent über Prompt Injection umlenken lässt und was er danach anrichten kann.
Wie unterscheidet sich Red Teaming von Benchmarks und Penetrationstests?
Microsofts AI Red Team hat nach eigener Aussage mehr als 100 generative KI-Produkte getestet und daraus acht Lehren gezogen. Eine davon lautet: AI Red Teaming ist kein Sicherheits-Benchmarking. Red Teaming braucht deutlich mehr menschliche Arbeit, kann aber neue Arten von Schäden aufdecken und Risiken im konkreten Einsatzkontext prüfen.
Umgekehrt ersetzt Red Teaming keine systematische Messung. Microsoft rät, Einzelbeispiele aus einem Red Teaming nicht als Maß dafür zu lesen, wie häufig ein Problem auftritt. Das BSI nennt in der Checkliste seines Leitfadens zu Evasion-Attacks von Januar 2026 deshalb beides als Test des fertigen LLM-Systems: Benchmarking und Red Teaming.
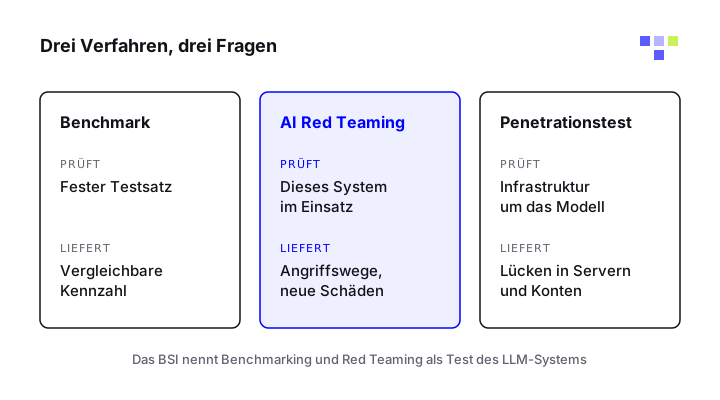
| Verfahren | Frage | Ergebnis |
|---|---|---|
| Benchmark | Wie schneidet das Modell auf einem festen Testsatz ab? | Vergleichbare Kennzahl, findet nur, was im Testsatz steht |
| AI Red Teaming | Wie lässt sich genau dieses System im Einsatz missbrauchen? | Konkrete Angriffswege und neue Schadensarten |
| Klassischer Penetrationstest | Wo hat die Infrastruktur rund um das Modell Lücken? | Schwachstellen in Servern, Schnittstellen und Konten |
Wie läuft AI Red Teaming ab?
Microsoft beschreibt die Planung eines Red Teamings für LLM-Anwendungen in mehreren Phasen vor, während und nach dem Test. Für KI-Agenten im Unternehmen ergibt sich daraus diese Schrittfolge.
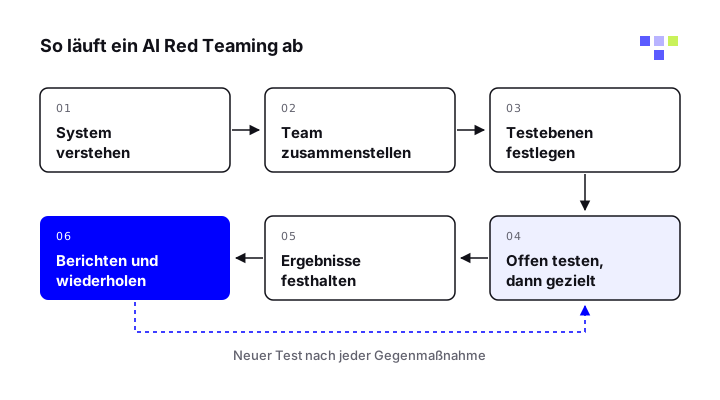
System verstehen
Klären Sie, was der Agent kann und wo er eingesetzt wird: Daten, Werkzeuge, Rechte, Nutzer. Microsoft nennt das als erste Lehre aus seinen Tests.
Team zusammenstellen
Mischen Sie Sicherheitsfachleute mit Angreiferdenken und Fachanwender, die das System nicht mitentwickelt haben. Jeder bekommt Schadensarten oder Funktionen zugewiesen.
Testebenen festlegen
Getestet wird das Basismodell mit seinen Schutzfiltern, die Anwendung selbst und beides vor und nach den Gegenmaßnahmen, möglichst über die echte Oberfläche.
Offen testen, dann gezielt
Eine erste offene Runde sammelt Probleme und ergibt eine Liste von Schäden. Folgerunden prüfen diese Liste gezielt und ergänzen neue Funde.
Ergebnisse festhalten
Jeder Fund wird mit Datum, Eingabe, Ausgabe und einer Kennung dokumentiert, damit er sich nachstellen lässt.
Berichten und wiederholen
Ein kurzer Bericht nennt die wichtigsten Probleme und den Plan für die nächste Runde. Nach jeder Gegenmaßnahme folgt ein neuer Test.
Was ein Red Team bei KI-Agenten prüfen sollte
Eine gute Gliederung liefert die OWASP Top 10 für LLM-Anwendungen 2026. Die Tabelle zeigt typische Testfragen für einen Agenten mit Zugriff auf Mail, Dokumente und Werkzeuge. Die vollständige Liste mit allen Gegenmaßnahmen steht auf der Seite zur OWASP Top 10 LLM.
| Testfrage | OWASP-Eintrag 2026 |
|---|---|
| Folgt der Agent Anweisungen, die in einer Mail, Webseite oder Datei versteckt sind? | LLM01 Prompt Injection |
| Gibt er Daten preis, auf die der anfragende Nutzer kein Recht hat? | LLM02 Sensitive Information Disclosure |
| Kann er nach einer Manipulation Mails senden, Dateien löschen oder Zahlungen auslösen? | LLM03 Excessive Agency |
| Lassen sich Systemprompt, Werkzeugschemata oder interne Regeln auslesen? | LLM08 Hidden Context Exposure |
| Erzeugt er Links oder Markdown-Bilder, über die Inhalte nach außen abfließen? | LLM10 Improper Output Handling |
| Lassen sich Kosten durch Endlosschleifen oder riesige Eingaben in die Höhe treiben? | LLM06 Unbounded Consumption |
Testen Sie nicht nur direkte Eingaben im Chat. Bei Agenten kommt der Angriff meist über Inhalte, die der Agent selbst liest. Wie diese indirekte Prompt Injection abläuft, gehört in jeden Testplan.
Werkzeuge für AI Red Teaming
Automatisierung deckt mehr Angriffsvarianten ab, als ein Mensch von Hand eingeben kann. Microsoft berichtet, dass sein Werkzeug PyRIT dem eigenen Red Team half, wichtige Schwachstellen schneller zu finden. Zugleich warnt Microsoft, solche Werkzeuge nicht mit dem Ziel einzusetzen, den Menschen aus dem Test zu nehmen.
Die drei bekanntesten quelloffenen Werkzeuge sind in der Tabelle aufgeführt. Sie eignen sich für wiederholbare Prüfungen nach jeder Änderung.
| Werkzeug | Herkunft und Lizenz | Wofür |
|---|---|---|
| PyRIT | Microsoft, MIT-Lizenz | Quelloffenes Red-Teaming-Toolkit für generative KI mit automatisierten Prüfungen und mehrstufigen, sich anpassenden Angriffen. |
| garak | NVIDIA, Apache-2.0-Lizenz | Schwachstellenscanner für LLMs. Prüft laut Projekt auf Halluzinationen, Datenlecks, Prompt Injection, Jailbreaks und weitere Schwächen. |
| Promptfoo | MIT-Lizenz, laut Projekt Teil von OpenAI | Testet Prompts, Agenten und RAG-Systeme und bietet Red Teaming und Schwachstellenscans für KI-Anwendungen. |
Promptfoo bezeichnet sich laut eigenem Repository inzwischen als Teil von OpenAI. Prüfen Sie bei jedem Werkzeug vor dem Einsatz, wohin Testdaten und Ergebnisse übertragen werden.
Was verlangt die KI-Verordnung zum Red Teaming?
Ausdrücklich verlangt die KI-Verordnung (EU) 2024/1689 Angriffstests nur von Anbietern von KI-Modellen mit allgemeinem Verwendungszweck mit systemischem Risiko. Nach Artikel 55 Absatz 1 Buchstabe a müssen sie eine Modellbewertung nach dem Stand der Technik durchführen, wozu auch die Durchführung und Dokumentation von Angriffstests gehört. Anhang XI Abschnitt 2 nennt dazu interne und externe Angriffstests, „zum Beispiel Red Teaming“.
Ein systemisches Risiko wird nach Artikel 51 Absatz 2 vermutet, wenn für das Training mehr als 10²⁵ Gleitkommaoperationen eingesetzt wurden. Das betrifft die Hersteller großer Modelle. Die Pflichten aus Kapitel V gelten nach Artikel 113 seit dem 2. August 2025.
Für Hochrisiko-KI-Systeme verlangt Artikel 15 Absatz 5 Widerstandsfähigkeit gegen Versuche unbefugter Dritter, das System über Schwachstellen zu manipulieren. Nach der Änderung durch die Verordnung (EU) 2026/1744 gelten diese Anforderungen ab dem 2. Dezember 2027 für Systeme nach Anhang III und ab dem 2. August 2028 für Systeme nach Anhang I. Ob Ihr Einsatz darunter fällt, erklärt die Seite zur KI-Verordnung.
Wer nur einen fertigen KI-Agenten einsetzt, ist in der Regel kein Anbieter eines Modells mit systemischem Risiko. Artikel 55 gilt dann nicht unmittelbar. Ein eigenes Red Teaming kann trotzdem helfen, die Robustheit nachzuweisen, die Artikel 15 für Hochrisiko-Systeme fordert.
Wann lohnt sich AI Red Teaming für Unternehmen?
Je mehr ein Agent darf, desto eher lohnt der Test. Ein interner Chat ohne Werkzeuge und ohne vertrauliche Daten braucht meist nur einen kurzen Selbsttest. Ein Agent, der Kundenmails liest und selbst antworten darf, gehört vor dem Start auf den Prüfstand.
OWASP empfiehlt Red Teaming und Evaluierungen auch bei der Auswahl fremder Modelle, bezogen auf Ihren Anwendungsfall, und laufend gegen versteckte Hintertüren durch Poisoning. Microsoft betont, dass die Arbeit an sicheren KI-Systemen nie abgeschlossen ist.
- Der Agent hat Zugriff auf vertrauliche Daten wie Kunden- oder Personaldaten.
- Er liest fremde Inhalte: Mails, Webseiten, Tickets oder hochgeladene Dateien.
- Er kann nach außen handeln, also senden, buchen, löschen oder Code ausführen.
- Er ist für Kunden oder die Öffentlichkeit erreichbar.
- Modell, Systemprompt oder Werkzeuge haben sich seit dem letzten Test geändert.
Grenzen des Red Teamings und was danach kommt
Ein Red Teaming zeigt, dass Angriffe möglich sind, beweist aber keine Sicherheit. Microsoft stellt fest, dass einfache Techniken oft genauso gut funktionieren wie aufwendige mathematische Angriffe.
Die Funde fließen deshalb in Gegenmaßnahmen, die auch gegen unbekannte Angriffe wirken. Was sich gegen Jailbreaks tun lässt, zeigt die Seite zum KI-Jailbreak. Für Agenten gelten die vier Regeln der Site.
Rechte begrenzen
Werkzeuge und Berechtigungen kürzen, die das Red Team missbrauchen konnte.
Freigaben einbauen
Vor kritischen Aktionen entscheidet ein Mensch, siehe Human in the Loop.
Eingaben trennen
Fremde Inhalte als Daten markieren und von Anweisungen getrennt verarbeiten.
Protokollieren
Werkzeugaufrufe mitschreiben, damit der nächste Test und echte Vorfälle nachvollziehbar sind.
Häufige Fragen
Was ist der Unterschied zwischen AI Red Teaming und einem Penetrationstest?
Ein Penetrationstest sucht Lücken in Servern, Schnittstellen und Konten. AI Red Teaming prüft zusätzlich das Verhalten des Modells: ob es sich umlenken lässt, Daten preisgibt oder schädliche Inhalte erzeugt. Bei KI-Agenten gehört beides zusammen.
Ist AI Red Teaming nach der KI-Verordnung Pflicht?
Ausdrücklich nur für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck mit systemischem Risiko (Artikel 55 Absatz 1 Buchstabe a). Unternehmen, die fertige Agenten einsetzen, trifft diese Pflicht in der Regel nicht.
Für Hochrisiko-KI-Systeme fordert Artikel 15 Absatz 5 Widerstandsfähigkeit gegen Manipulation; ein Red Teaming ist ein Weg, das zu prüfen.
Welche Tools gibt es für AI Red Teaming?
Verbreitete quelloffene Werkzeuge sind PyRIT von Microsoft, garak von NVIDIA und Promptfoo, das inzwischen zu OpenAI gehört. Sie automatisieren Angriffe über Schnittstellen. Microsoft rät, sie als Ergänzung zu menschlichen Testern zu nutzen.
Wie oft sollte man ein KI-System red teamen?
Vor dem ersten Einsatz und nach jeder wesentlichen Änderung an Modell, Systemprompt oder Werkzeugen. Automatisierte Tests lassen sich in jeden Release einbauen, ein menschliches Red Teaming lohnt sich bei größeren Änderungen und neuen Funktionen.
Wer sollte im Red Team sitzen?
Microsoft empfiehlt eine Mischung: Sicherheitsfachleute mit Angreiferdenken und Fachanwender, die das System nicht mitentwickelt haben. NIST nennt zusätzlich Teams aus Menschen und KI, weil KI-gestütztes Red Teaming kostengünstiger sein kann als menschliche Tester allein.
Quellen
- Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1), NIST
- Lessons From Red Teaming 100 Generative AI Products, Microsoft AI Red Team (arXiv:2501.07238)
- Planning red teaming for large language models (LLMs) and their applications, Microsoft Learn
- Evasion-Attacks auf LLMs: Gegenmaßnahmen in der Praxis (Version 1.0, Januar 2026), BSI
- OWASP Top 10 for LLM Applications 2026, OWASP GenAI Security Project
- PyRIT: Python Risk Identification Tool for generative AI, Microsoft (GitHub)
- garak: LLM vulnerability scanner, NVIDIA (GitHub)
- promptfoo, Promptfoo (GitHub)
- Verordnung (EU) 2024/1689 (KI-Verordnung), Artikel 15, 51, 55, 113 und Anhang XI, EUR-Lex
- Verordnung (EU) 2026/1744 (Digital-Omnibus zur KI), EUR-Lex